
AI大模型竞争:群雄逐鹿,谁能在这场激战中脱颖而出?
在当今科技飞速发展的时代,AI大模型竞争愈发激烈,成为全球科技领域关注的焦点。各大科技巨头纷纷投身其中,致力于打造更强大、更智能的模型,以抢占未来科技高地。
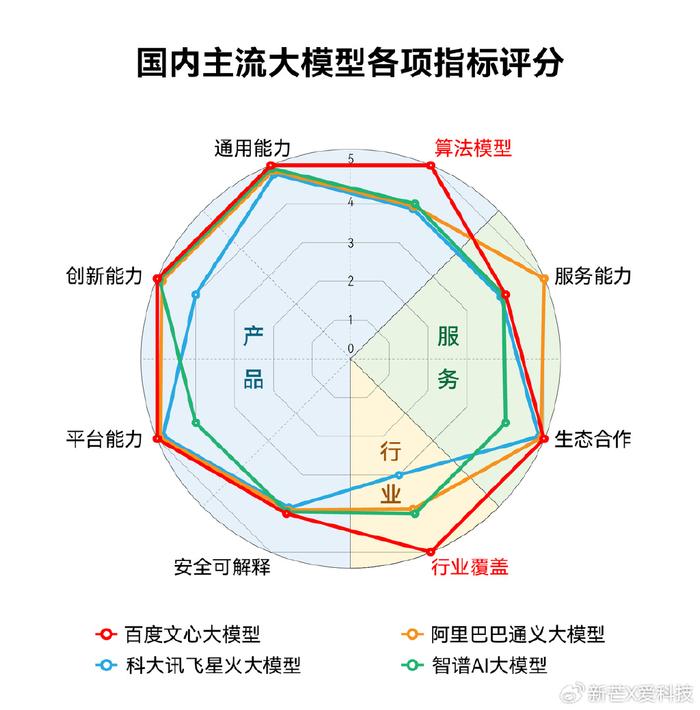
AI大模型的竞争,本质上是一场关于技术创新、数据资源和人才储备的全方位较量。技术创新是核心驱动力。那些能够突破传统算法局限,开发出更高效、更精准模型架构的企业,往往能在竞争中脱颖而出。例如,谷歌的BERT模型,通过引入双向编码器表征,显著提升了自然语言处理的性能,为众多自然语言处理任务带来了新的突破。这种创新不仅体现在算法本身,还包括对模型训练优化、模型压缩等方面的持续探索。其他公司也在不断努力,如OpenAI的GPT系列,以其强大的语言生成能力吸引了广泛关注。这些模型通过大规模的无监督学习,在海量文本数据上进行训练,从而获得了卓越的语言理解和生成能力。
数据资源同样至关重要。丰富且高质量的数据是训练出优秀模型的基础。拥有大规模数据的企业,可以让模型学习到更广泛的语言模式、知识和语义信息。数据就像是模型成长的养分,充足的数据能够滋养模型,使其在各种任务中表现得更加出色。例如,一些公司通过与各大数据供应商合作,获取了来自互联网、社交媒体、学术文献等多领域的海量数据,为模型训练提供了坚实保障。而数据的标注质量也直接影响模型的性能,精确标注的数据能够引导模型更准确地理解数据中的含义,从而提高模型的预测准确性。
人才储备是这场竞争的关键因素之一。顶尖的数据科学家、工程师和研究人员汇聚在一起,才能推动AI大模型不断向前发展。他们具备深厚的数学基础、扎实的编程能力以及对AI技术的敏锐洞察力。这些人才能够深入研究模型架构、优化算法,解决模型训练过程中遇到的各种复杂问题。例如,一些知名科技企业不惜重金吸引全球优秀人才,组建强大的研发团队。这些团队成员来自不同的背景,有着不同的专业技能,他们相互协作、相互启发,共同攻克技术难题,为企业在AI大模型竞争中赢得优势。
在这场激烈的竞争中,各企业纷纷采取不同的策略。有的专注于特定领域的模型优化,如医疗领域的AI模型,通过对医疗数据的深入分析,帮助医生进行疾病诊断、治疗方案推荐等;有的则致力于拓展模型的应用场景,将其应用于智能交通、智能家居等多个领域,以实现更广泛的社会价值。开源合作也成为一种趋势。一些企业开源自己的模型代码和数据集,促进了整个AI社区的技术交流与进步。这种开源合作不仅有助于企业提升自身品牌影响力,还能借助全球开发者的智慧,共同推动AI大模型技术的发展。
AI大模型竞争也带来了一些挑战。其中,和安全问题备受关注。随着模型的能力不断增强,其可能产生的数据偏见、隐私泄露等问题日益凸显。例如,在招聘场景中,AI模型可能因数据偏差而对某些群体产生不公平的评价。恶意利用AI模型进行网络攻击、虚假信息传播等行为也给社会安全带来威胁。因此,在追求技术进步的必须加强对AI技术的规范和安全监管,确保其健康、可持续发展。
AI大模型竞争正处于白热化阶段,技术创新、数据资源和人才储备是竞争的关键要素。各企业通过不同策略推动模型发展,但也需应对和安全等挑战。只有在创新与规范并行的道路上,AI大模型才能为人类社会创造更多福祉,引领科技迈向新的高度。未来,这场竞争仍将持续,谁能在这场角逐中把握关键,谁就能在AI时代占据领先地位,塑造科技发展的新格局。
相关文章