
AI总结生成:助力海量信息快速提炼核心价值
在信息密度呈指数级攀升的数字时代,普通人每天要面对工作邮件、行业研报、社交平台动态、课程录播、学术文献等海量文本与多模态内容,光是筛选有效信息、梳理内容逻辑就要耗费近三分之一的日均精力,AI总结生成技术的规模化落地,恰好为这种普遍存在的“信息过载困局”提供了低成本、高效率的解决方案。
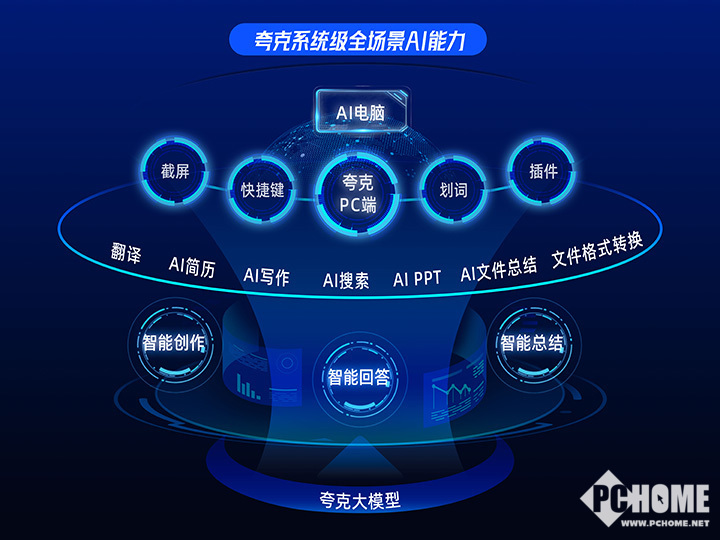
早在上世纪五六十年代,学界就已经开启了自动文本摘要技术的探索历程,早期的抽取式总结主要依托词频统计、TextRank算法等逻辑,通过识别关键词、关键句的权重直接从原文中截取片段拼接成摘要,这种方式虽然能保证内容的“原文准确性”,却经常出现逻辑跳脱、语句不通顺的问题——比如总结一篇数十页的行业研报时,算法可能会把位于不同章节、毫无关联的两个数据放在同一段落里,让用户看得一头雾水,更不用说梳理清楚研报的论证链条和核心结论了。直到预训练大模型技术成熟,AI总结生成才真正实现了从“机械拼接”到“理解重构”的跨越:基于Transformer架构的大模型通过海量文本的学习,掌握了不同领域的语言逻辑和知识框架,能够先完整理解输入内容的核心主旨、论证结构和关键信息,再用自然流畅的语言重新组织输出,甚至可以根据用户的需求调整总结的篇幅、风格和侧重点。如今的AI总结早已不局限于纯文本内容,多模态大模型的发展让它能够处理音频、、图文混排等多种形式的内容:一段两小时的课程录播,它可以先识别语音内容、提取PPT中的图表数据,再整合生成包含知识点框架、重点例题、拓展思考的完整笔记;一本配有大量手绘插图的科普读物,它也能结合文字和图像信息,生成兼顾知识性和趣味性的精简读本。
技术的落地最终要锚定真实的用户需求,AI总结生成正在悄无声息地嵌入不同行业的工作流与普通人的日常生活,重塑着人们处理信息的方式。对于高校研究者和学生来说,过去完成一篇文献综述往往需要通读上百篇中英文论文,光是梳理每篇论文的核心观点、研究方法和创新点就要耗费数周时间,现在借助AI总结工具,只需要上传文献包,就能快速得到每篇文献的核心摘要,还能按照研究主题、方法、结论进行分类聚类,甚至可以直接生成不同研究方向的对比表格,极大降低了文献梳理的时间成本。对于职场人而言,AI总结更是成了不可或缺的效率工具:动辄两三个小时的跨部门会议,结束后不需要专人整理录音,AI就能自动生成包含决策结论、待办事项、责任人和时间节点的结构化会议纪要,还能自动同步到项目管理系统中;面对几十页的客户需求文档、竞品分析报告,AI可以在几分钟内提炼出核心诉求和关键差异,让从业者把更多精力放在方案设计和问题解决上,而不是埋在海量文档里找信息。对于普通大众来说,AI总结也早已不是遥远的技术概念:刷到十几分钟的科普、时事评论,只需要点击“AI看全文”“内容总结”按钮,就能快速get核心观点,不用再拖着进度条找重点;追更的网络小说更新了好几章,赶时间的时候可以先看AI生成的章节梗概,既不会错过关键剧情,也不耽误日常安排。在公共服务领域,AI总结的价值同样不容忽视:过去动辄几十页的政策文件,普通民众往往因为专业术语过多、内容太繁杂而不愿细读,如今各地政务平台引入AI总结功能后,可以针对不同群体生成定制化的解读版本——给企业经营者的版本重点梳理税收减免、营商环境优化的相关条款,给普通市民的版本则聚焦社保、医保、落户等民生相关的内容,甚至可以转化为方言口语版的音频,让政策信息真正触达不同圈层的群体。
不过,AI总结生成技术的快速普及也伴随着不少亟待解决的问题,其中最受关注的就是“幻觉”风险。通用大模型在处理专业性较强的内容时,经常会为了保证逻辑通顺而编造不存在的信息:比如总结医学文献时,可能会把其他研究的结论张冠李戴,甚至虚构实验数据;总结法律条文时,可能会漏掉关键的限定条件,导致用户对法条的理解出现偏差,这些错误在医疗、法律、金融等容错率极低的领域,甚至可能造成严重的后果。除此之外,版权边界模糊也是AI总结面临的重要争议:如果AI对受版权保护的书籍、付费文章进行总结并对外提供服务,是否构成侵权?总结后的内容版权归属于原作者、AI开发者还是用户?这些问题目前还没有明确的法律界定。更值得警惕的是,长期依赖AI总结可能会弱化人们的深度阅读和独立思考能力:当人们习惯了直接拿到“整理好的结论”,就会逐渐失去梳理复杂文本、拆解逻辑链条的耐心,甚至会被AI总结时自带的价值偏向所误导,陷入“被投喂观点”的信息茧房。数据安全风险同样不可忽视,很多用户在使用公共AI总结工具时,会不经意间上传包含商业秘密、个人隐私的内容,这些数据一旦被泄露或者滥用,将会带来难以估量的损失。
面对这些问题,AI总结生成技术正在向着更精准、更安全、更个性化的方向迭代。为了解决“幻觉”问题,越来越多的总结工具开始引入“原文溯源”功能,总结内容中的每一个核心观点都会标注对应的原文位置,用户可以随时点击校验内容的真实性;针对垂直领域的专业需求,很多企业也在开发行业定制化的总结大模型,通过在医疗、法律、金融等领域的专业语料上进行微调,大幅提升专业内容总结的准确率。在个性化层面,未来的AI总结将不再是“千人一面”的输出,而是可以根据用户的知识背景、使用场景、阅读习惯调整内容:给行业小白的总结会用更通俗的语言解释专业术语,甚至补充相关的背景知识;给资深从业者的总结则会直接聚焦前沿动态和核心数据,省略基础概念的介绍。多模态总结的深度融合也是重要的发展方向,未来的AI总结不仅能提炼文字和语音信息,还能分析中的画面情绪、图表数据、肢体语言等细节,给出更全面、更立体的总结结果。与此相关的行业规范和法律法规也在逐步完善,从数据安全、版权边界、内容审核等多个层面划定AI总结应用的红线,为技术的健康发展保驾护航。
从本质上看,AI总结生成从来不是为了替代人类的思考,而是为了把人类从低效、重复的信息筛选工作中解放出来,让我们有更多时间和精力去做更有创造力的事情——比如基于总结的信息做出判断、提出新的观点、解决更复杂的问题。技术本身没有对错,关键在于我们如何使用它:既不能因为担心风险就全盘否定技术的价值,也不能盲目依赖技术而失去独立思考的能力。只有在技术迭代的同时守住人的主体性,让AI总结成为我们拓展认知边界、提升效率的,才能真正让这项技术服务于人的发展,在信息爆炸的时代帮我们找到更清晰的认知坐标。
相关文章