
突破算力瓶颈 AI性能优化的核心方法与落地实践
在人工智能技术快速渗透到千行百业的当下,大模型参数量从十亿级向千亿、万亿级跃迁的速度越来越快,行业对AI系统的性能要求也早已不再局限于“能跑通”,而是转向了“跑得稳、跑得快、成本低”的综合目标——毕竟,一个在实验室里能跑出优异精度的模型,如果在产业落地时面临推理延迟过高、算力成本失控、资源利用率不足等问题,终究无法真正转化为生产力。也正因为如此,AI性能优化已经从过去研发流程里的“收尾环节”,变成了贯穿模型设计、训练、部署、运维全生命周期的核心工作,其技术路径也随着硬件架构的迭代、业务场景的细分不断拓展出新的边界。
从技术底层来看,AI性能优化的第一个核心维度是算法层面的轻量化与结构重构。过去很多人对算法优化的理解停留在“剪枝、量化、蒸馏”这传统三件套上,但随着模型架构的演进,优化的思路已经变得更加前置:比如在大模型设计阶段,研究者就会通过稀疏注意力机制替代全注意力计算,把原本O(n²)的时间复杂度降到接近线性,从根源上减少长序列场景下的计算量;又比如混合专家(MoE)架构的普及,本质上也是一种性能优化的思路——通过让每一次计算只激活部分专家网络,在维持模型整体参数量的前提下,大幅降低单token推理的实际计算开销。而传统的量化技术也在不断进化,从早期的INT8量化到如今的INT4、甚至INT2量化,配合更精细的权重量化策略与激活值校准方法,已经能在精度损失可控的前提下,把模型的显存占用和计算延迟降到原来的几分之一,让原本只能在高端算力卡上运行的大模型,也能部署在消费级显卡甚至端侧设备上。知识蒸馏的应用场景也在不断拓宽,除了用大模型“教”小模型,还出现了针对特定场景的任务级蒸馏,把通用大模型的能力浓缩到适配单一业务的小模型里,既保留了核心能力,又大幅提升了运行效率。
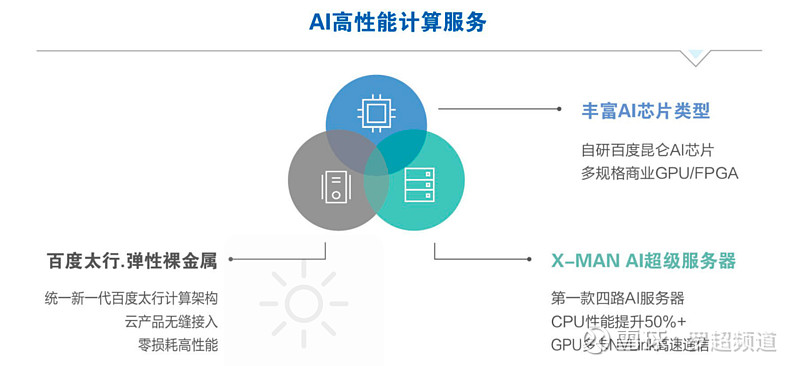
如果说算法优化是从“软件逻辑”上给AI瘦身,那么硬件层面的适配与协同优化就是给AI找最合适的“跑鞋”。如今AI算力的载体早已不再是单一的通用GPU,而是形成了从云端训练芯片、边缘推理芯片到端侧NPU的多元化硬件矩阵,不同硬件的架构特性差异极大,想要充分释放算力潜力,就必须针对硬件特性做深度适配。比如针对NVIDIA GPU的CUDA核心与Tensor Core,开发者会通过算子融合、访存优化等手段,把原本零散的计算操作合并成更适合张量核心执行的指令,同时减少GPU显存与高带宽缓存之间的数据搬运开销——毕竟在很多AI计算场景里,访存延迟才是制约性能的核心瓶颈,而非计算单元本身的算力。针对FPGA这类可重构硬件,工程师则会根据模型的计算流定制专用的计算通路,在特定场景下能获得比通用芯片高得多的能效比。而在端侧场景,比如手机、智能穿戴、车载设备上的AI部署,性能优化更是要精细到每一个操作的算力分配,比如利用移动端NPU的定点计算优势处理卷积、全连接这类计算密集型算子,把逻辑判断类的操作留给CPU,通过异构调度让不同计算单元各司其职,最终实现低功耗下的低延迟推理。
在算法与硬件之外,系统级的调度与工程化优化同样是AI性能提升的关键抓手,尤其是在大模型训练和大规模推理集群的场景下,系统层面的优化往往能带来数量级的性能提升。比如大模型训练中的分布式并行策略,早已从简单的数据并行,发展出了张量并行、流水线并行、序列并行等多种技术,工程师需要根据模型的参数量、集群的网络带宽、显存容量等条件,组合出最优的并行方案,让成千上万张算力卡能够高效协同工作,避免出现“一边忙死、一边闲等”的情况。而在推理服务层面,动态批处理、连续批处理等技术的普及,把原本单次处理一个请求的模式改成了批量处理,大幅提升了GPU的利用率;针对长对话场景的KV缓存优化,比如分页缓存、量化缓存等技术,能够显著降低显存占用,让单卡能同时服务更多的并发请求。除此之外,AI编译器的作用也越来越重要,它能够把上层框架写的模型代码,自动编译优化成适配不同硬件的底层执行图,自动完成算子融合、布局转换、内存分配优化等工作,把开发者从繁琐的手工调优中解放出来,同时也能覆盖很多人工优化容易忽略的细节。
值得注意的是,AI性能优化从来不是“只追求速度不管精度”的单项选择题,而是需要在精度、速度、成本、功耗等多个维度之间找到最佳平衡点,而且这个平衡点会随着业务场景的变化而变化。比如在工业质检这类对精度要求极高的场景,性能优化的底线是不能降低缺陷检测的准确率,优化的重点就会放在冗余计算的删减和硬件资源的高效利用上;而在实时交互类的场景,比如智能语音对话、AR眼镜的实时识别,延迟是核心指标,这时候就可以在可接受的精度范围内,尽可能压缩模型体积、减少计算步骤。甚至同一个模型在不同的部署环境下,优化策略也完全不同——在云端集群里,带宽和算力相对充足,优化重点可能是提升并发吞吐量、降低单位请求的成本;而在端侧设备上,功耗和内存限制更严格,优化重点就要转向模型轻量化和低功耗计算。
随着生成式AI的应用越来越广泛,AI性能优化的技术也在不断朝着自动化、全栈化的方向发展。比如现在出现的自动机器学习(AutoML)和自动优化工具,能够根据业务需求和硬件环境,自动搜索最优的模型结构和量化策略,把过去依赖专家经验的调优工作
相关文章