
AI赋能数据处理全链路 深度挖掘数据核心价值
在数字经济深度渗透千行百业的当下,每秒都有以PB为单位的异构数据从智能终端、工业传感器、社交平台、医疗设备等多元场景中持续生成,这些庞杂的数据蕴藏着决定企业竞争力、行业发展方向甚至社会治理效能的核心价值,而AI数据处理正是激活这一价值的关键技术底座。
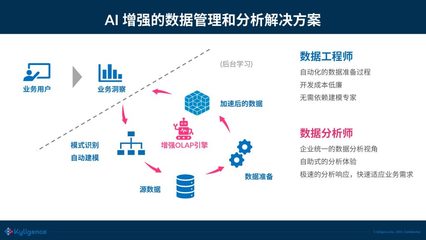
与传统依赖人工规则、仅能覆盖结构化数据的处理模式不同,AI数据处理打通了结构化、半结构化、非结构化数据的处理壁垒,构建起从数据采集、清洗、标注、分析到价值输出的全链路智能化体系,彻底打破了过去“数据多但用不起来”的行业困局。
在整个AI数据处理链路中,数据预处理是耗时最长、对最终效果影响最大的环节,行业内素来有“七分数据三分模型”的说法。传统的数据标注与清洗高度依赖人工,以自动驾驶领域的激光雷达点云数据为例,标注一个包含行人、车辆、交通标识的复杂路口场景,熟练的标注员需要花费3到4小时,且容易因疲劳、主观判断差异出现标注误差。而引入AI预标注技术后,大模型可以先对90%以上的常规目标完成自动标注,人工仅需对边缘场景、模糊目标进行校验和修正,整体标注效率可提升5到8倍,标注一致性也能从人工的75%左右提升至95%以上。国内某头部新能源车企曾公布过一组数据,其自动驾驶路测每天会产生近100TB的多模态数据,过去需要近200人的标注团队周转近1个月才能形成可用的训练数据集,在搭建全流程AI数据处理管线后,数据处理周期压缩至7天,人力成本下降65%,得益于标注数据的一致性提升,其自动驾驶模型的泛化能力较此前提升了28%。
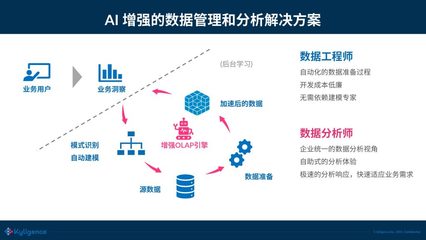
如果说预处理是AI数据处理的“基础底座”,那么智能分析与价值挖掘就是其“核心引擎”。传统数据处理大多停留在描述性分析阶段,只能通过统计报表回答“发生了什么”,却难以挖掘数据背后的深层关联,更无法对未来趋势做出预判。而AI数据处理依托深度学习、特征工程等技术,可以从海量多维度数据中捕捉到人类难以察觉的隐性规律,实现从“描述现状”到“预测未来”再到“辅助决策”的跃迁。在零售行业,传统库存管理仅能依据历史销量做周期性补货,常常出现畅销品缺货、滞销品积压的问题。而接入AI数据处理系统后,平台可以整合历史销量、天气变化、节假日安排、周边商圈活动、社交平台话题热度甚至上游供应链物流波动等上百个维度的数据,实时预测不同区域、不同门店各SKU的未来7天销量,进而给出最优补货量、陈列位置甚至动态定价策略。某连锁商超品牌应用该技术后,整体库存周转效率提升32%,缺货率下降41%,滞销品损耗减少了近一半。在医疗领域,AI数据处理可以打通患者的电子病历、影像报告、基因检测数据、可穿戴设备采集的生活习惯数据等多源异构信息,对慢性病高危人群进行提前预警,其准确率比传统基于单一指标的筛查方式高出40%以上,还能为患者生成个性化的饮食、运动干预方案,真正实现了从“治病”到“防病”的医疗服务升级。
当然,AI数据处理的快速发展也伴随着一系列亟待解决的问题,其中数据隐私安全与算法公平性最受关注。随着《数据安全法》《个人信息保护法》等法规的落地,数据使用的合规门槛不断提高,如何在保护用户隐私的前提下充分挖掘数据价值,成为AI数据处理必须突破的核心命题。眼下,以联邦学习、差分隐私、同态加密为代表的隐私计算技术正在成为重要的解决方案,比如金融行业多家机构联合构建反欺诈模型时,无需共享各自的用户核心数据,只需通过联邦学习框架在本地完成数据处理,仅交换加密后的模型参数,就能实现联合建模提升反欺诈准确率,既满足了合规要求,又释放了数据价值。数据偏见带来的算法公平性问题也不容忽视,如果训练数据本身存在历史偏见,AI数据处理的结果就可能放大歧视,比如部分招聘领域的AI筛选工具曾因历史数据中男性员工占比更高,自动降低女性简历的权重,引发了广泛争议。因此,现在的AI数据处理链路中普遍加入了公平性校验模块,主动识别数据中可能存在的性别、年龄、地域等偏见特征,通过重采样、权重调整等方式完成数据去偏,尽可能保证分析结果的公平公正。
随着多模态大模型、边缘计算等技术的不断迭代,AI数据处理的边界还在持续拓展。未来,AI数据处理将不再局限于中心化的云端处理,而是会向边缘侧延伸,让海量物联网设备产生的数据在本地就能完成实时分析与决策,进一步降低数据传输成本与安全风险。大模型的普及也会让AI数据处理的门槛持续降低,即使是没有专业技术能力的中小企业员工,也能通过自然语言交互完成复杂的数据分析需求,真正让数据价值惠及千行百业,成为推动数字经济高质量发展的核心动力。
相关文章